最初想折腾智能音箱,是因为一种越来越明显的落差。
大模型已经能帮我解释问题、讨论方案、写代码,手机里的模型入口也越来越丰富。但回到家里,前几年买的智能音箱,在我的日常使用中似乎仍停留在比较有限的问答和指令上。小爱同学、天猫精灵这些熟悉的名字,曾经让“对着设备说句话”变得自然,却没有让我感受到同样幅度的能力变化。
于是就有了一个很直接的念头:如果给音箱接上大模型,它能不能更聪明一点?除了播放音乐、设置闹钟,也能回答更广泛的问题,遇到专业一点的话题,还可以继续聊下去。
从家里的音箱,想到办公室里的同事
接触到 Skills,以及一些关于 Agent 参与日常工作的讨论后,我开始想:办公室里能不能也有一个这样的入口?平时安静地待在桌上,需要时喊一声,就能帮忙找资料、记下事情,甚至调用已有程序,执行一些具体任务。
比如讨论方案时,问它某份文档里是怎么约定的;临时想到一件事,让它先记下来;会议结束后,再查询之前讨论过的结论。
这些都是我希望它将来能做到的事。想到这里,目标已经从“让音箱更会回答问题”,逐渐变成了一个能通过语音参与工作的办公室助手。我把它想象成一位可以被唤醒的机器人同事。
不过,想象可以先放远一点,动手还是得从眼前的条件开始。
用手边的盒子和会议音箱开始
手边刚好有一台 RK3588 盒子,运行 Ubuntu,配了 8GB 内存,也承担着其他服务。再接上一台 USB 会议麦克风音箱一体机,收音和播放就有了现成的硬件入口。
这套组合很适合拿来做第一次试验:盒子运行程序,会议音箱负责听和说,先看看语音交互究竟能做到什么程度。这次实际搭建的是一套独立原型,还没有改造家里那些品牌音箱。
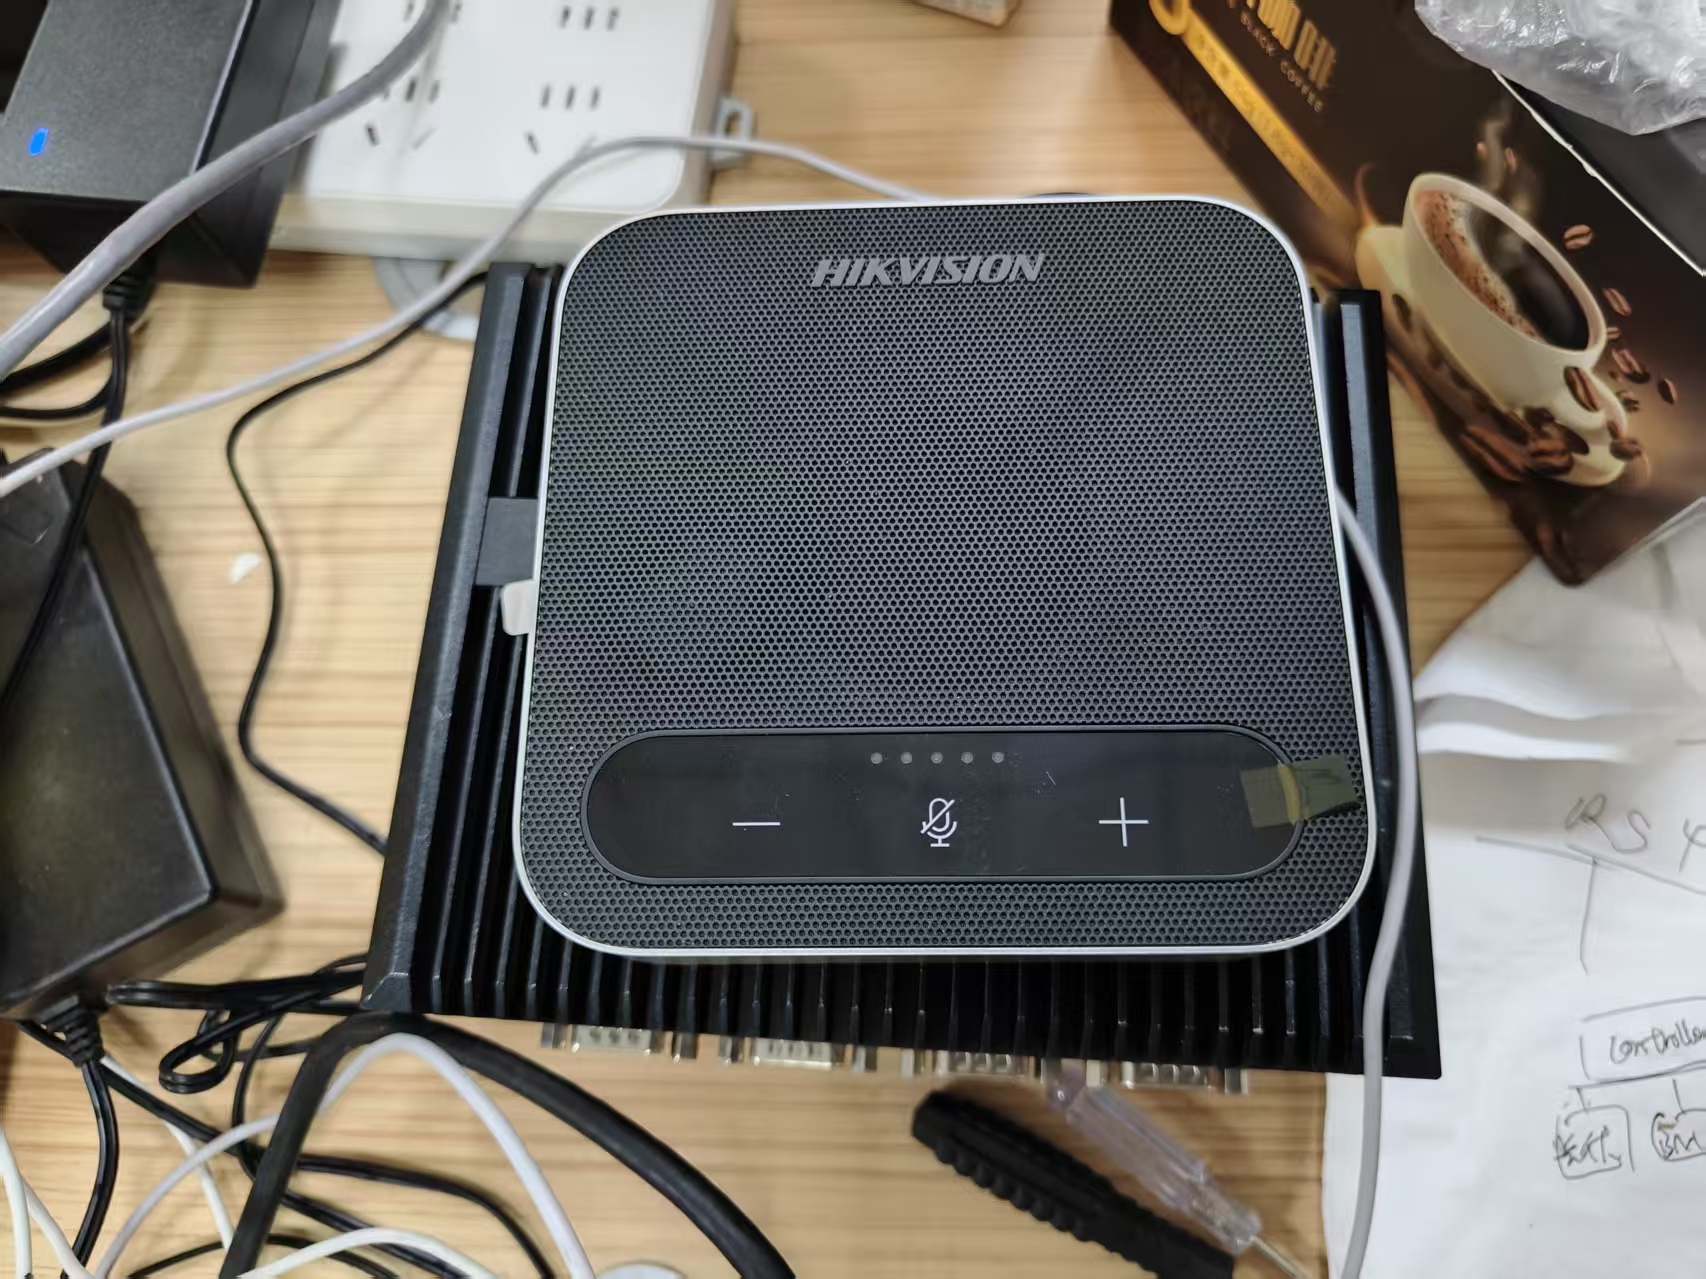
我当时最想要的是一个尽快跑起来的 MVP,也就是最小可行原型。先让它开口,让我能真实地问几句、追问几句,再决定值不值得继续投入。
几份方案比较后,先把范围收小
方案讨论并没有一开始就这么轻。
最初整理出来的版本已经考虑了唤醒、语音识别、语音合成、多轮会话、常驻运行,以及后续扩展。每一项单独看都有道理,放在一起,却开始像是在提前建设一套完整系统。
于是我又把方案交给 DeepSeek 和豆包评估。加上最初的版本,几份思路摆在一起,讨论的重点逐渐从“应该具备哪些模块”,转向“第一轮到底需要验证什么”。
有的思路倾向把更多环节放到云端,减少盒子上的模型依赖;有的保留本地语音处理,再调用远程大模型。几轮讨论后,我选择了一条混合路线:本地处理唤醒、断句和语音识别,大模型通过云端 API 调用,回答再由联网语音合成服务转换成声音。
第一轮暂时不做完整的工具系统,也不急着加入长期记忆、开机常驻和复杂的工程分层。先验证最基本的中文问答体验。
一句话,怎样变成回答
真正实施时,第一步甚至还没有涉及大模型,而是确认硬件能不能正常工作。
系统能否识别 USB 设备,麦克风能否录到现场声音,声音能否从预期的音箱播放出来,这些都需要实际确认。设备出现在列表里,只能说明系统认出了它;录到人声、听到回放,才算走过了最基础的一关。
这一步通过后,才开始逐段连接后面的能力:唤醒 → 收音并判断一句话是否说完 → 语音转文字 → 大模型生成回答 → 文字转语音 → 音箱播放。
其中,判断“有没有人在说话、是不是说完了”的环节叫 VAD(语音活动检测)。它负责划分语音片段,并不理解内容。**ASR(语音识别)**再把声音转成文字,**LLM(大语言模型)**根据文字回答,**TTS(语音合成)**则把回答重新变成声音。
这一版用 sherpa-onnx 承载中文唤醒、Silero VAD 和 SenseVoice INT8 语音识别,通过 DeepSeek API 获取回答,再用 Edge-TTS 合成中文语音。生成的音频经过 ffmpeg 解码后,由 PulseAudio 送到 USB 音箱播放。
RK3588 在这里承担的是本地语音处理和程序调度,大模型并没有部署在盒子上,也还没有使用它的 NPU。当前语音识别在本地进行,但问题与会话上下文会发给云端 LLM,回答文字也会发给联网 TTS;这套原型仍然依赖网络。
程序先从终端手动触发开始,随后接入中文唤醒,后来又把唤醒词配置成了“小光”。新词的现场命中和误唤醒情况还需要继续试。模型、环境和调用逐项接好后,一条简单的语音问答通路终于有了。
真正聊起来,落差很快出现
首先是识别准确性。
有些话没有被正确转成文字,后面的大模型收到的就已经是错误的问题。它可能很认真地解释,也可能回答得很流畅,可整个方向从输入开始就偏了。
这让我更直接地体会到,语音助手的能力并不只取决于大模型。说的话有没有收清楚、断句有没有截掉内容、识别结果是否准确,都会影响最后的体验。模型再会回答,也不能保证它知道我原本想问什么。
接着是不能打断。
为了尽快实现,首版采用半双工:我说完,它处理,然后播放回答,播完再听下一句。这个顺序很容易理解,实现也相对简单,但用起来很容易着急。
尤其当前一句已经识别错了,我知道它接下来会答偏,却无法立刻插话纠正,只能等它继续说完。一段在屏幕上可以扫过去的文字,变成语音后,就成了一段必须等待的时间。
到了这里,“能回答”和“愿意继续跟它聊”之间的距离,已经很明显了。
更大的落差,是它还不能办事。
我希望它查一下资料,它还没有文件查询工具;希望它找最新信息,它还没有联网搜索能力;希望它记下一件事情,它也还没有接入可持续保存、再次查询的记录系统。
接上大模型,只是让它获得了一部分理解和表达能力。资料从哪里来、记录存在哪里、任务由谁执行、执行后怎样确认结果,都需要程序继续接起来。
因此,现阶段它还是一个很简陋的 Demo。它证明了这套硬件可以作为语音入口,也打通了语音与 LLM 之间的基本通路,但还没有成为我设想中的办公室助手。
下一轮,从一件真的有用的小事开始
回头看,这一轮 MVP 的价值,是让我更清楚地知道下一轮该验证什么。
最初我比较关注模型怎么选、组件怎么接、盒子的资源够不够。实际聊过以后,最在意的问题变得很具体:它有没有听懂?答错时能不能马上纠正?能不能查到一份真实资料,完成一件小事?
这些问题也让我重新审视首版的裁剪。为了尽快跑通,把打断和工具能力放到了后面,确实降低了实现难度,但也暂时拿掉了很大一部分我真正想要的体验。
接下来还需要判断,是继续完善当前这个简单程序,还是引入更成熟的语音会话框架。路线尚未定下来,新的框架是否适合这台盒子,也需要实际验证。
不过,下一轮想得到的结果已经清楚了:用真实说话场景改善识别,允许在回答过程中打断和纠正,再接入一个足够小、却真的有用的能力,比如查询指定目录里的文档,回答时能够指出出处。
等这件事做好,再考虑会议记录,以及更进一步的任务执行。
我仍然对那位“办公室同事”的设想有兴趣。只是现在知道,要让它在桌上值得被喊一声,除了会说话,还得能接住人的话,并把一件事情做出结果。
这次先把硬件和通路跑通,也把那些差距留了下来。下一次,就从找一份资料、接受一次打断这样的小事继续试。